Token 花得比预算多,钱多半漏在这几个地方
来源:江小鱼 时间:2026-11-03 15:21:41阅读:23
AI 功能上线后,费用常常比预估高。多数情况不是单价变了,而是用量浪费在了一些不显眼的地方。想降本,先别急着换模型,先看看钱花在哪。
模型调用费用主要取决于输入和输出 Token、历史对话长度、重复调用、缓存命中情况和模型档位。这些环节都有优化空间。
首先是重试与失败重跑。请求超时、格式错误、自动重试,都可能造成重复调用。如果上一次请求已经执行完成,只是客户端没收到响应,再次请求就可能重复计费。建议按功能统计失败率和重试比例,优先处理问题严重的环节。
其次是输出长度。很多模型的输出 Token 单价高于输入。让模型过度解释、没有设置输出上限,或者 JSON 字段要求不明确,都可能产生不必要的输出。明确回答格式和长度,通常就能减少费用。
重复上下文也是一笔容易忽略的开销。如果每次请求都带上相同的系统提示、产品手册和知识片段,就会增加输入成本。支持前缀缓存的模型,可以把固定内容放前面,命中缓存的部分通常按更低价格计费。但需要满足前缀一致性和缓存长度等条件。
聊天功能还要注意多轮累积。对话越长,每次请求携带的历史记录越多,输入 Token 也会增加。可以只保留最近几轮,或将早期对话压缩成摘要,保留真正有用的信息。
模型也不必一味追求最贵的。分类、抽取、改写等简单任务,小模型通常就能胜任;复杂任务再交给大模型。可以通过规则检查和格式校验筛选结果,不符合要求时再升级处理,但要先验证小模型的实际效果。
对于离线数据处理、夜间报表等不急着返回结果的任务,可以考虑批处理。部分模型提供更低的批处理价格,但结果返回时间较长,具体要看服务商的计费规则。
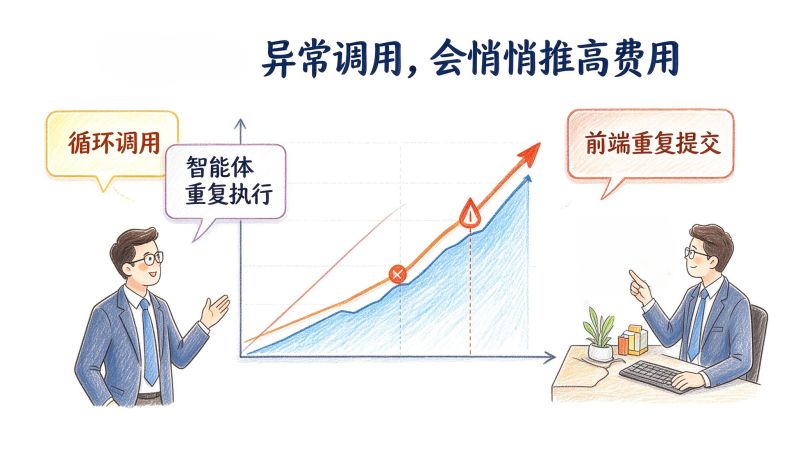
最后还要排查异常调用。循环调用、智能体重复执行任务、前端重复提交,都可能增加不必要的费用。建议按功能统计 Token 用量和实际费用,并设置日用量告警,及时发现异常增长。
优化时不要一次全改。先看一两周日志,找出费用最高的环节,逐项调整并验证效果,这样才能知道钱究竟省在了哪里。
声明:本网站发布的内容(图片、视频和文字)以用户投稿、用户转载内容为主,如果涉及侵权请尽快告知,我们将会在第一时间删除。文章观点不代表本网站立场,如果涉及侵权请联系站长邮箱:shawn.lee@vecloud.com进行举报,并提供相关证据,一经查实,将立刻删除涉嫌侵权内容。
本站原创内容未经允许不得转载,或转载时需注明出处:https://news.kd010.com/hlw/24048.html
TAG标签:
 赞
 电话
 微信