大模型是自己部署还是调 API,账要这么算
来源:江小鱼 时间:2026-11-09 13:13:14阅读:40
企业要做 AI 功能,绕不开这个问题:模型是自己部署一套,还是直接调 API?一边说自建可控,一边说调用省事,听起来都有道理,落到预算上却常常算错。
模型选型、应用开发、数据整理和提示词调试,是两种方式都需要投入的部分。真正的差别在于前期算力投入、长期使用成本,以及业务是否有特殊要求。
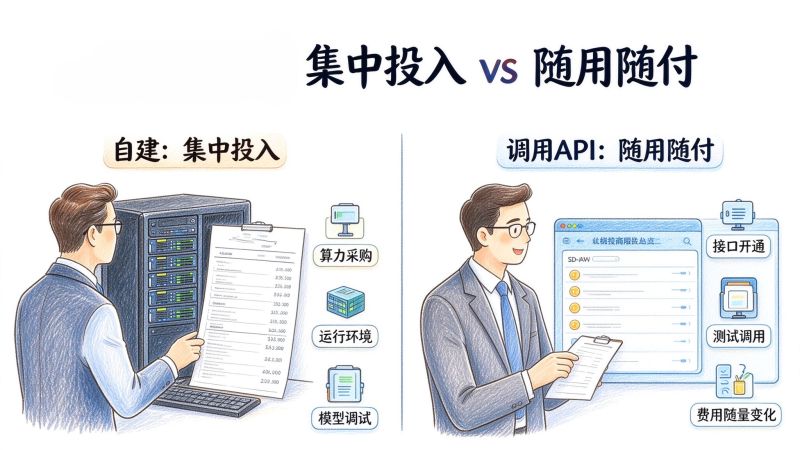
前期投入方面,自建需要购买或租用算力,还要准备运行环境、调试模型性能,前期投入相对集中。调用 API 则不需要提前准备算力,开通接口就能测试,费用随调用量变化。虽然接口集成和应用开发仍然需要成本,但更适合还处于验证阶段的业务。
长期用量方面,如果业务量大、使用稳定,且算力利用率较高,自建更容易摊薄硬件采购和折旧成本。但电费、设备维护和扩容也要算进去。如果业务量小、波动大,设备长期闲置,反而可能不如调用 API 划算。
隐性成本方面,自建不仅是买设备,还需要持续跟进模型更新、版本升级和性能优化。机器故障、显存不足等问题也需要专人处理,这些都是长期投入。
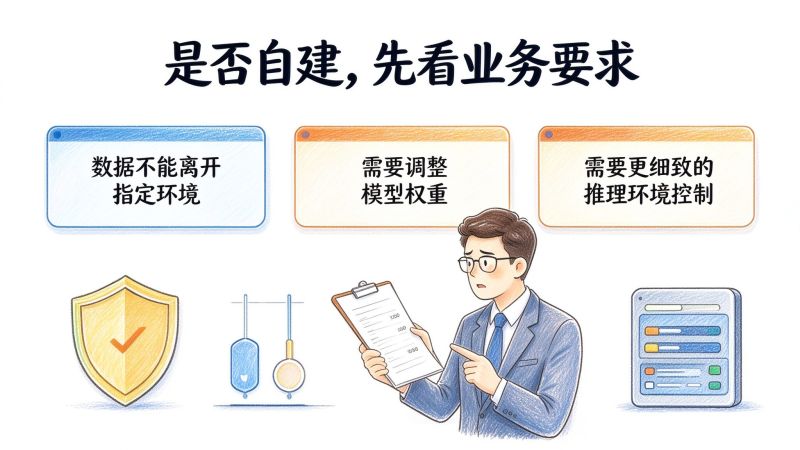
除了成本,还要看业务需求。如果客户隐私、生产数据或监管要求数据不能离开指定环境,可以考虑本地部署、私有化部署或符合要求的专属服务,是否必须自建要看具体的合规要求。
如果需要调整模型权重,或对推理环境和底层配置进行更细致的控制,自建会更灵活。不过,微调和系统集成并不一定要求自建,部分 API 服务也支持这些能力。
团队的运维能力同样重要。自建需要有人负责性能优化、版本升级和故障排查。如果缺少技术人员,设备也可能长期闲置。
对于业务需求差异较大的企业,还可以采用混合部署:核心、敏感业务使用自建模型,其他功能调用 API。不过,这种方式需要同时维护两套接入和运维体系,不一定能降低成本,只有确实存在数据安全、性能或成本方面的差异时才值得考虑。
最终决策不能只看每月调用量,还要结合模型规格、输入输出 Token 比例、并发量、响应速度和高峰算力需求,分别计算 API 费用与自建的硬件、运维成本,才能判断哪种方式更划算。
如果您的团队正在推进大模型构建,GPU算力和稳定的网络环境是关键。Vecloud推出的GPU服务器托管、本地网络接入服务,可以为您的研究提供强大支持——无论是深度学习、图像处理还是其他高性能计算任务。了解更多,欢迎与我们联系。
声明:本网站发布的内容(图片、视频和文字)以用户投稿、用户转载内容为主,如果涉及侵权请尽快告知,我们将会在第一时间删除。文章观点不代表本网站立场,如果涉及侵权请联系站长邮箱:shawn.lee@vecloud.com进行举报,并提供相关证据,一经查实,将立刻删除涉嫌侵权内容。
本站原创内容未经允许不得转载,或转载时需注明出处:https://news.kd010.com/hlw/24051.html
TAG标签:
 赞
 电话
 微信